技术中心:北京 · 北京东燕郊开发区东方夏威夷U栋
营销中心:北京 · 石景山区北方中惠国际中心D座

技术中心:北京 · 北京东燕郊开发区东方夏威夷U栋
营销中心:北京 · 石景山区北方中惠国际中心D座
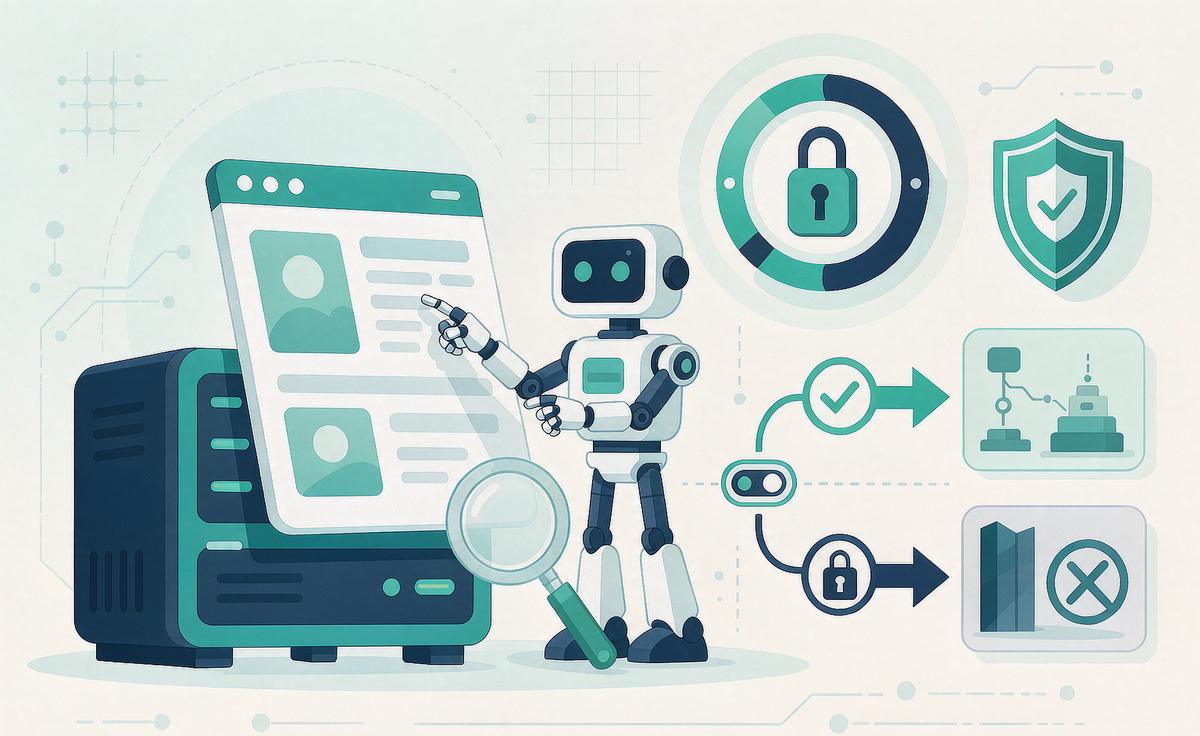
最近不少企业主问:后台日志里出现GPTBot、ClaudeBot这些陌生爬虫,该不该放它们进站?放行怕内容被白拿,屏蔽又怕错过AI搜索的引用机会。深耕北京小程序开发与GEO优化的团队观点很明确:这不是二选一,而是一套分级策略。按下面四步定,官网才能"被抓得其所"。
第一步:先盘点,弄清谁在来。主流AI爬虫各有明确分工:OpenAI的GPTBot负责训练数据、OAI-SearchBot负责联网检索,Anthropic的ClaudeBot、PerplexityBot、字节跳动的Bytespider等各有角色,身份核对以各家官方文档公布的UA为准。先统计近30天日志里AI爬虫的访问频次和命中路径,再谈策略,不要凭感觉一刀切。
第二步:分级设置robots.txt。通行做法是分层:知识库、行业洞察、案例拆解这类内容营销页面对检索型爬虫全放行——这正是AI搜索引用的入口;训练型爬虫按企业策略决定,在意内容被用于训练的就Disallow;后台、接口、隐私页面对所有爬虫一律封禁。注意robots只表达"愿不愿意被抓",防不了恶意抓取,安全要另靠访问控制。
第三步:给付费和敏感内容上锁。会员内容、报价体系、未公开资料不能只靠robots,要在服务端做登录校验。放行的页面也要控制节奏:设置合理的抓取频率限制或服务器限流,避免高峰期被大量AI请求拖慢官网——抓取压力过大时,正常搜索引擎的抓取体验也会被殃及。
第四步:用日志验证,按效果调整。策略定完不是终点:每月回看日志,确认放行的爬虫确实按规则来;在AI搜索里用行业问题实测,看官网内容是否开始被引用。如果放行两个月仍无任何引用、带宽成本却明显上升,就有理由收紧范围。可同步部署llms.txt给AI一份官方内容导读,与robots配合效果更好。
总结:AI爬虫策略的本质是把"全放"或"全禁"变成分级管理——盘点来者、分层设置、保护敏感内容、用数据验证。策略要跟随业务目标走:想让AI搜索带来曝光,就把可公开的干货页敞开;想守住核心资产,就在服务端上锁。每季度复审一次配置,别让半年前的设置拖住现在的目标。


扫一扫,有惊喜
微信扫一扫,联系智禧科技